最近看到很多博主在推荐一个开源项目:Audiblez。
它能在本地把 EPUB 电子书转换成 M4B 有声书。
看到这个项目时,我最先想到的是:
如果以后一本电子书可以直接由 AI 生成有声书,传统配音行业会不会受到很大的冲击?
但真正把项目安装下来、跑了一遍以后,我发现事情没有看上去那么简单。
Audiblez 解决了什么问题?
Audiblez 的使用方式并不复杂。
给它一本 EPUB,它会提取书里的正文,通过 TTS 模型生成朗读音频,最后封装成可以在有声书播放器中使用的 M4B 文件。
它解决的是:
如何把一本电子书,快速变成一份可以播放的有声书。
而且它可以在本地运行,不需要把文档上传到第三方平台。
对于小说、课程资料、企业内部文档来说,这一点很有价值。
但它也有一个明显的问题:
声音由底层 TTS 模型决定。
虽然生成的语音已经能听,但如果想获得更有辨识度的声音,或者使用自己的声音,就没有那么容易了。
能不能把生成的音频换成另一种声音?
顺着这个问题,我又研究了 RVC。
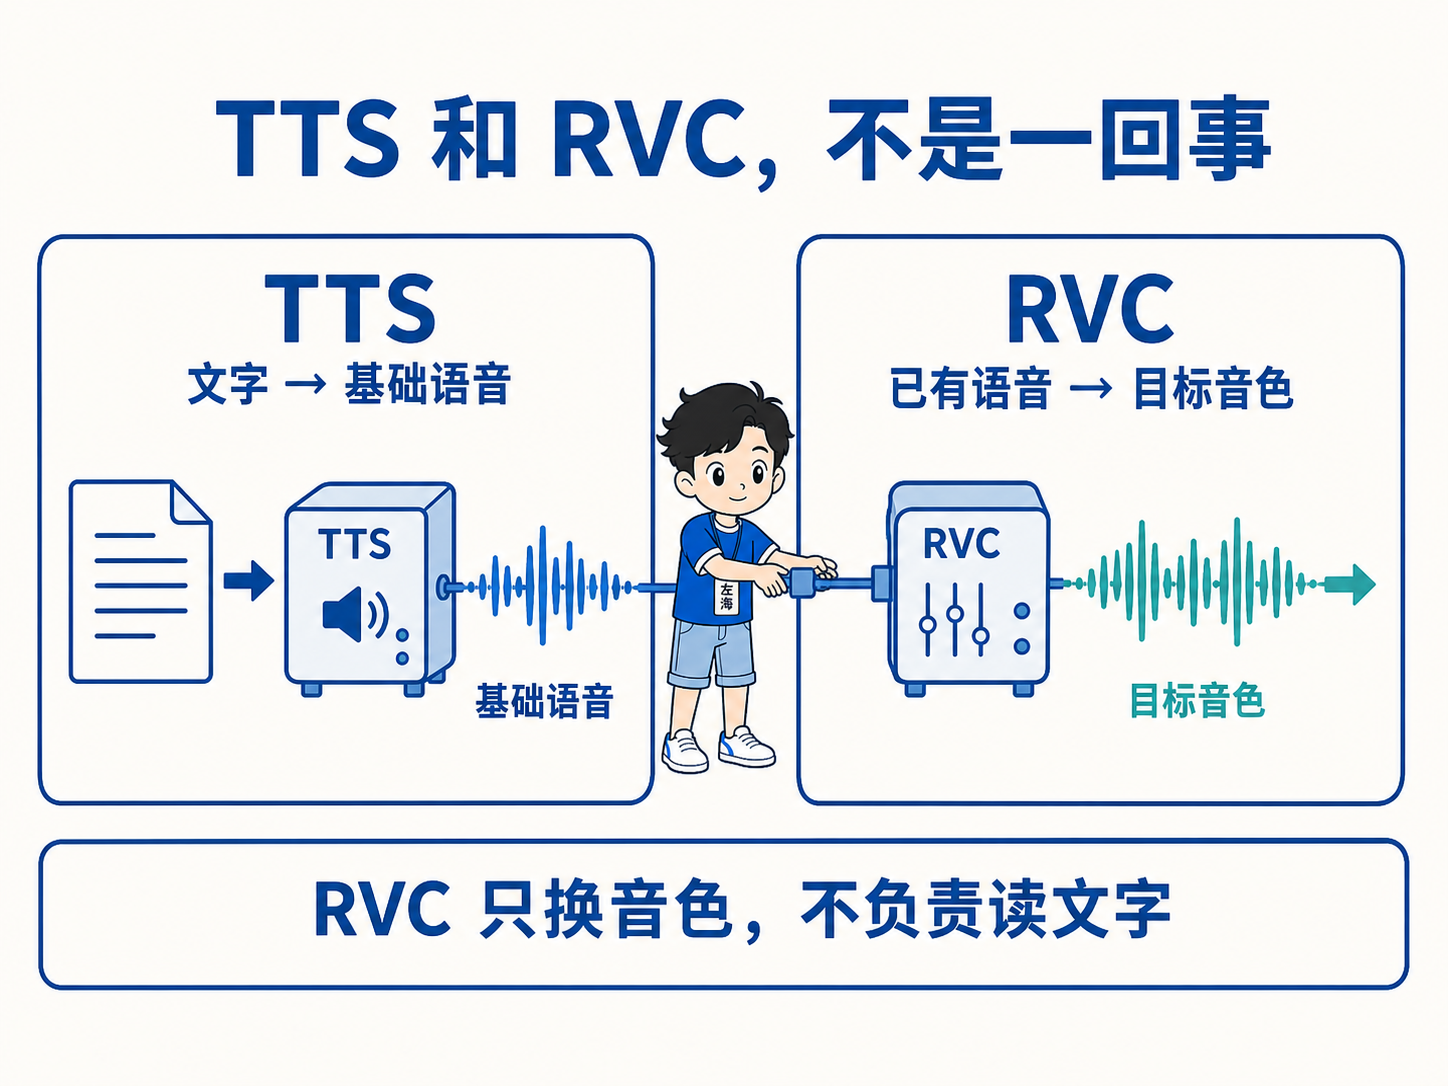
RVC 不是一个文字转语音工具。
它不能读取一本书,也不能直接把文字变成声音。
它做的事情更像是“声音转换”:
输入一段已经存在的语音,再把它转换成另一个目标音色。
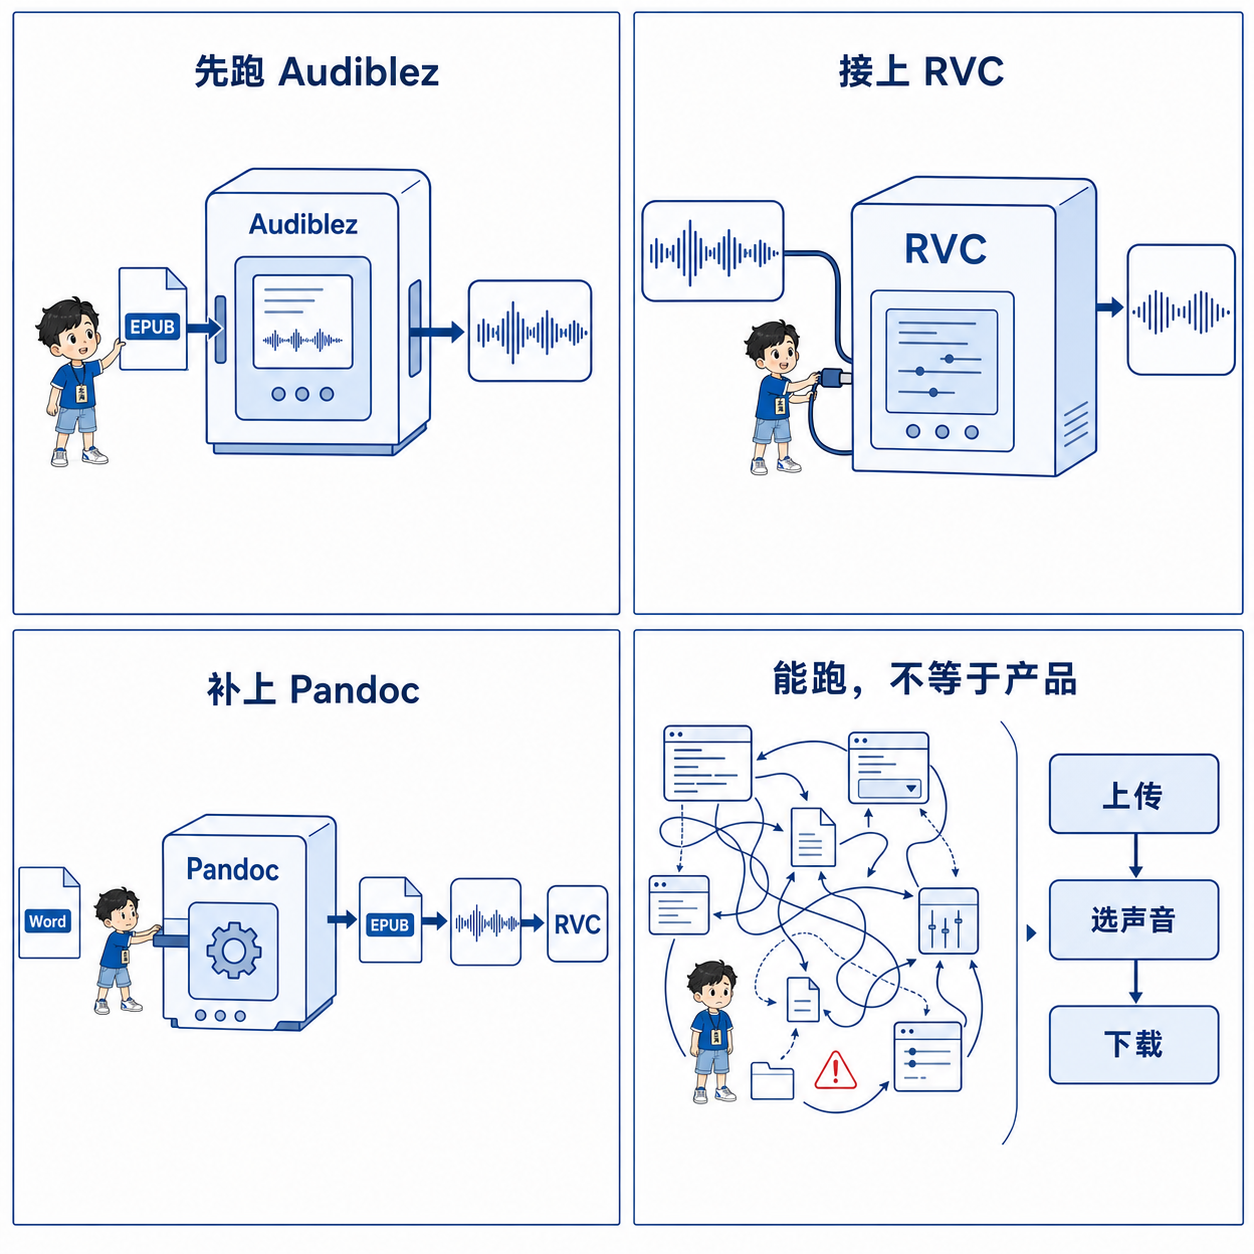
于是,最初的链路变成了:
电子书
↓
Audiblez 生成普通朗读音频
↓
RVC 转换成目标音色
↓
输出新的有声书
我用一段短文本做了测试。
先让 Audiblez 生成基础男声,再用 RVC 转换目标音色,最终成功得到了可以播放的 WAV 和 M4B 文件。
接着,我又使用接近4000字符的长文本进行测试,最终生成了大约6分多钟的完整音频。
到这里,技术链路已经可以跑通。
但普通用户手里并没有 EPUB
继续往下想,又遇到了一个现实问题。
Audiblez 的输入是 EPUB。
但绝大多数普通用户手里的资料并不是 EPUB,而是:
- Word
- TXT
- Markdown
- 网页文章
- 企业内部文档
不能要求普通用户先学习怎么制作一本电子书,再来生成音频。
所以还需要在前面增加一层文档转换。
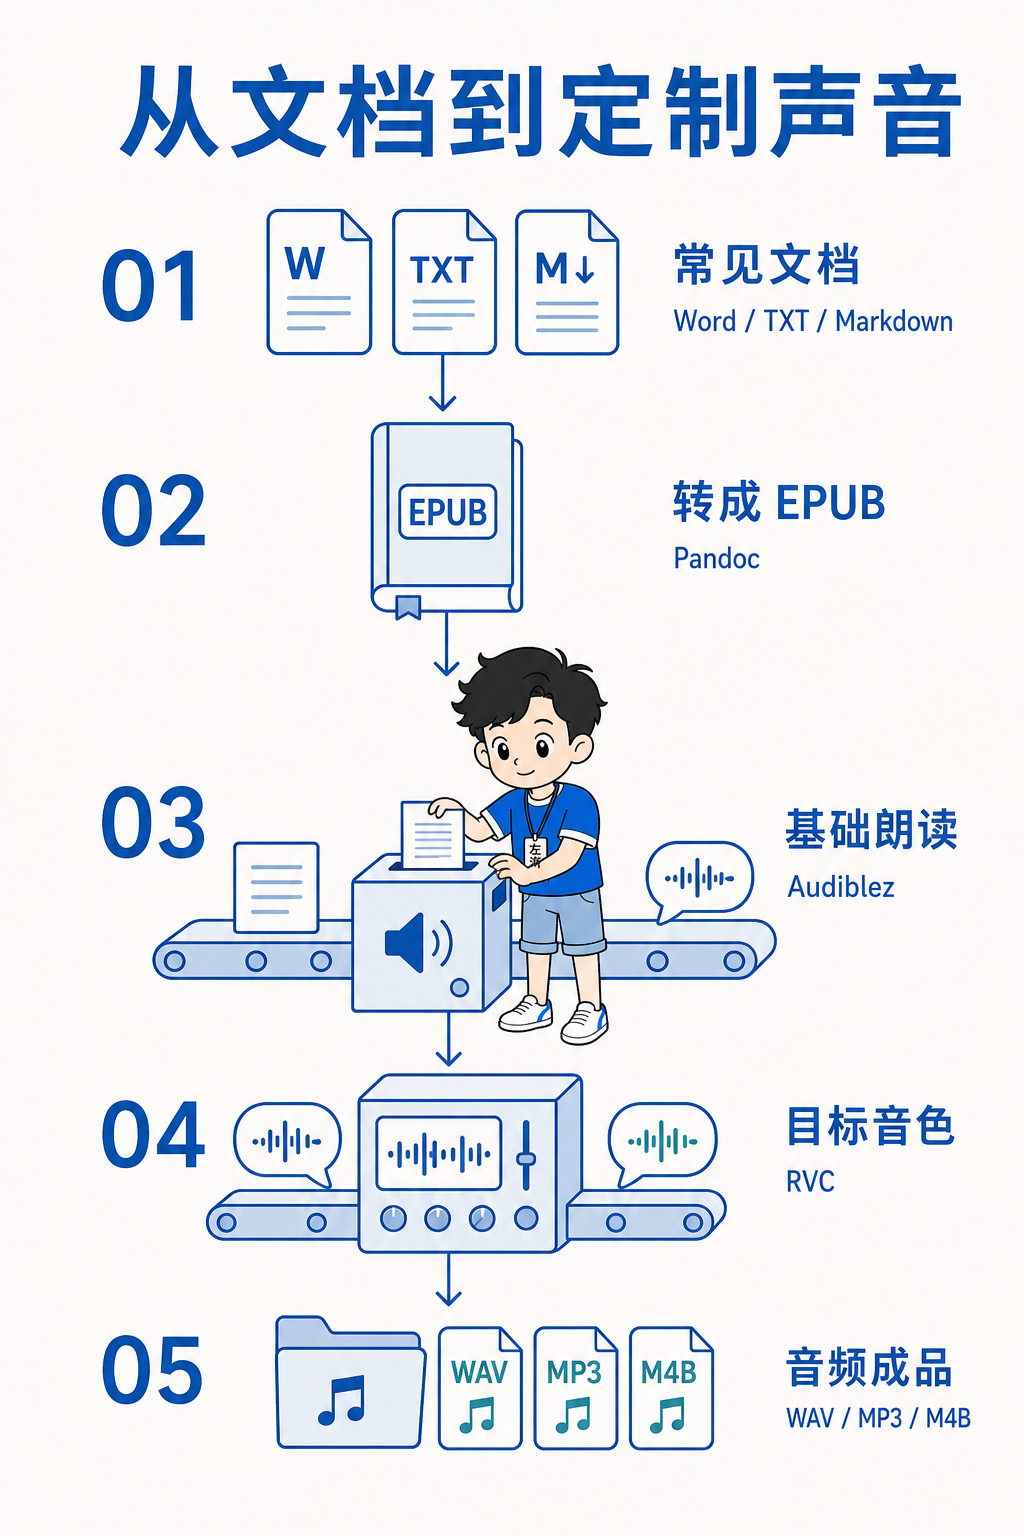
我最后选择了 Pandoc。
Pandoc 可以把 Word、TXT、Markdown、HTML 等常见文档统一转换成 EPUB,再交给 Audiblez 处理。
这样,整条链路最终变成:
Word、TXT、Markdown 等文档
↓
Pandoc 转换成标准 EPUB
↓
Audiblez 生成基础朗读音频
↓
RVC 转换目标音色
↓
输出 WAV、MP3 或 M4B
现在,三个开源项目已经可以完成从普通文档到定制音色成品的完整转换。
三个项目能运行,不等于它已经是产品
把三个项目分别跑通以后,我意识到一个经常被忽略的问题:
技术链路跑通,只能算一个 Demo。
它离普通用户真正能用,还有很长距离。
目前的操作方式仍然比较麻烦:
用户需要自己转换文件、执行命令、复制音频、选择模型和调整参数。
如果中间某一步失败,还可能需要重新执行前面的流程。
一个真正可以使用的产品,不应该要求用户理解 Pandoc、EPUB、TTS、RVC、FFmpeg 或模型索引。
用户应该只做三件事:
- 上传文档
- 选择语言和声音
- 下载最终音频
剩下的工作全部由系统自动完成。
例如:
上传一份 Word
↓
系统自动识别章节和正文
↓
清理页眉、页脚、页码和不适合朗读的内容
↓
分章节生成语音
↓
转换成经过授权的目标音色
↓
生成带封面、章节和断点续听功能的有声书
这才是一个完整产品,而不是三个开源项目的简单拼接。
它可以解决哪些实际问题?
目前我能想到几个比较实际的场景。
1. 创作者制作有声内容
很多写作者有大量文章和电子书,但没有时间逐篇录音。
这套系统可以帮助他们把已有内容快速转换成音频,再发布到播客、有声书或会员内容平台。
2. 使用自己的声音生成内容
创作者可以在获得本人授权的情况下,训练自己的声音模型。
之后发布新文章或课程时,不需要每次重新录制,就能生成接近本人音色的音频。
3. 企业内部资料语音化
培训材料、产品手册和内部知识库可以转换成适合通勤时收听的音频。
对于不能上传到第三方平台的内部资料,本地处理尤其重要。
4. 无障碍和阅读辅助
视力不便、阅读困难,或者不方便长期看屏幕的人,可以把文档转换成更容易收听的形式。
5. 长文章和课程资料
很多人收藏了大量 PDF、Word 和长文章,却一直没有时间阅读。
把这些内容转换成音频后,可以在开车、散步或做家务时收听。
它会取代配音人员吗?
我现在的判断是:短期内不会。
AI 已经可以完成基础朗读,而且成本会越来越低。
大量只要求“把内容读出来”的低成本业务,确实可能逐渐由 AI 完成。
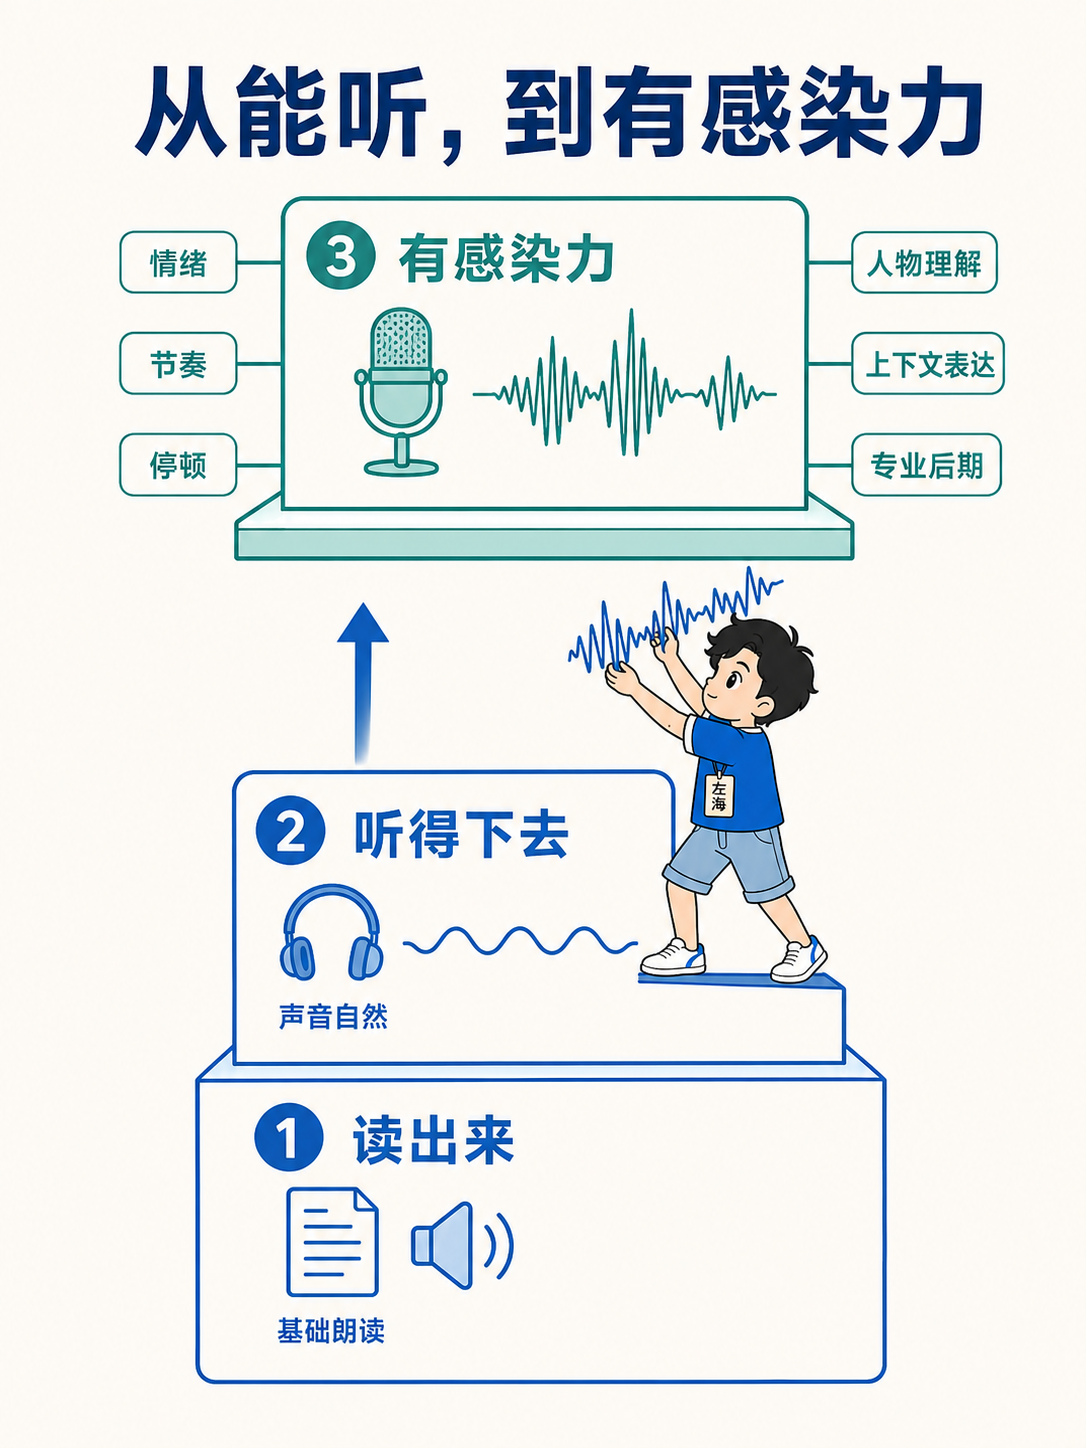
但真正高质量的配音不只是声音像不像,还包括:
- 情绪
- 节奏
- 停顿
- 人物理解
- 上下文表达
- 专业后期制作
目前把一篇文章转成可以听的音频并不难。
难的是把它变成一份真正有感染力、愿意让人连续听几个小时的作品。
所以它更可能先替代机械朗读,而不是直接替代专业配音。
声音克隆也存在明显风险
这项技术越容易使用,越需要考虑边界。
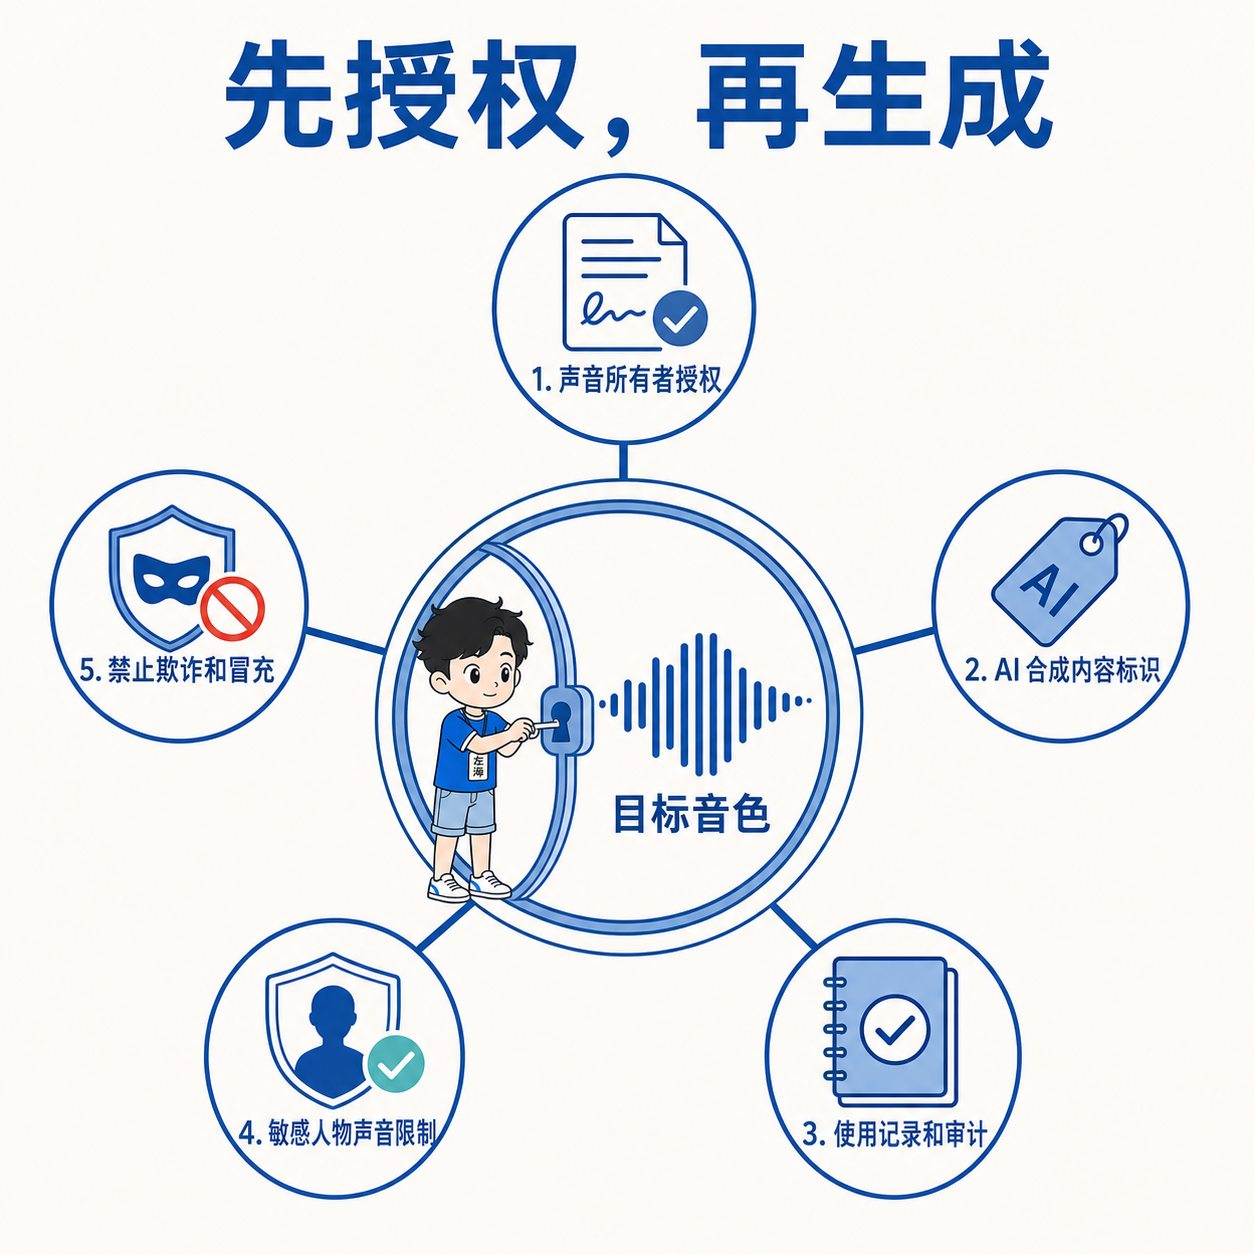
未经授权克隆真人或公众人物声音,可能被用于诈骗、虚假宣传和误导性内容。
如果将它产品化,至少需要具备:
- 声音所有者授权
- AI 合成内容标识
- 使用记录和审计
- 敏感人物声音限制
- 禁止欺诈和冒充用途
技术能实现,不代表所有使用方式都是合理的。
目前做到哪一步了?
我已经分别验证了:
- 普通文档转换成 EPUB
- EPUB 生成基础朗读语音
- 基础语音转换成目标音色
- WAV 和 M4B 文件输出
- 短文本处理
- 数分钟长文本处理
也就是说,核心技术链路已经跑通。
但要变成真正可以提供给用户的产品,还需要完成:
- 统一的网页界面
- 后台任务队列
- 进度显示
- 失败重试
- 文档清理
- 章节管理
- 模型和声音管理
- 权限、安全和审计
现在它更准确的状态是:
技术可行性已经验证,但用户需求和商业模式还没有验证。
最后一个问题
作为程序员,我很容易被“这条技术链路居然能跑通”这件事吸引。
但技术上能做出来,并不代表有人真的需要。
所以我更想知道:
你会在什么情况下,把一份 Word、PDF、文章或电子书转换成音频?
你更在意的是:
- 转换速度
- 声音自然度
- 使用自己的声音
- 文档隐私
- 价格
- 还是完全没有这个需求?
这三个项目的开源地址是:
现阶段,我要验证的不再是技术能不能跑,而是有没有人真正需要这样一套统一的内容生产系统。